国王-男性+女性=?新技术如何助力专利检索和查新
专利查重/查新几乎算是专利申请过程中最重要的一环。
如果同样的技术方案早已公开,申请文件写得再好,也不会让它变成一个新发明。
据团队已收集的数据,中国发明专利申请公开文献已有2200多万份。从海量的专利记录中找出与目标相关的资料是一项极具挑战的技术任务,更难的可能是想出你要搜什么关键词。
想找一支笔的设计,搜索“笔”就够了吗?
假设你想查找一种笔的设计,最先想到的关键词大概就是“笔”。
但相关资料里可能把它叫作“书写工具”,也可能叫作“书写装置”。
这是欧洲专利局给出的一个真实例子:一份关于笔的专利文献,使用的是“writing instrument”,也就是“书写工具”。如果使用“pen”这个关键词,并不能准确找到这份文献。
对人来说,这两种描述很容易联系起来,但字面上它们完全不同。
为了获得尽可能全面的搜索结果,我们需要尽可能多地联想类似关键词,再尝试不同的组合。词选太具体,可能漏掉关联结果,甚至搜不到结果。选词太宽泛,又会返回太多弱相关甚至不相关的结果。
有没有一种方式,可以让人不用那么费力地去想各种关键词?
按关键词搜,看的是字面:资料里有没有“笔”这个字。另一种办法,是比较意思是否相近。要比较意思,先得让计算机能用数字表示意思。
数字如何表示含义和关联
请用直觉回答这个问题:国王 - 男性 + 女性 ≈ ?
A:王子 B:女王 C:公主

计算机做这道题,先要用一组数字表示一个词。这组数字合起来,描述的就是这个词的意思,叫作“词向量”。
真实的词向量通常有几百上千个数字,是模型从大量文字里学来的,单看其中一个,往往说不清它指什么。为了好懂,我们假设只用 4 个一看就懂的特征:
- 王室:是不是王室成员
- 权威:权威有多高
- 男:是不是男性
- 女:是不是女性
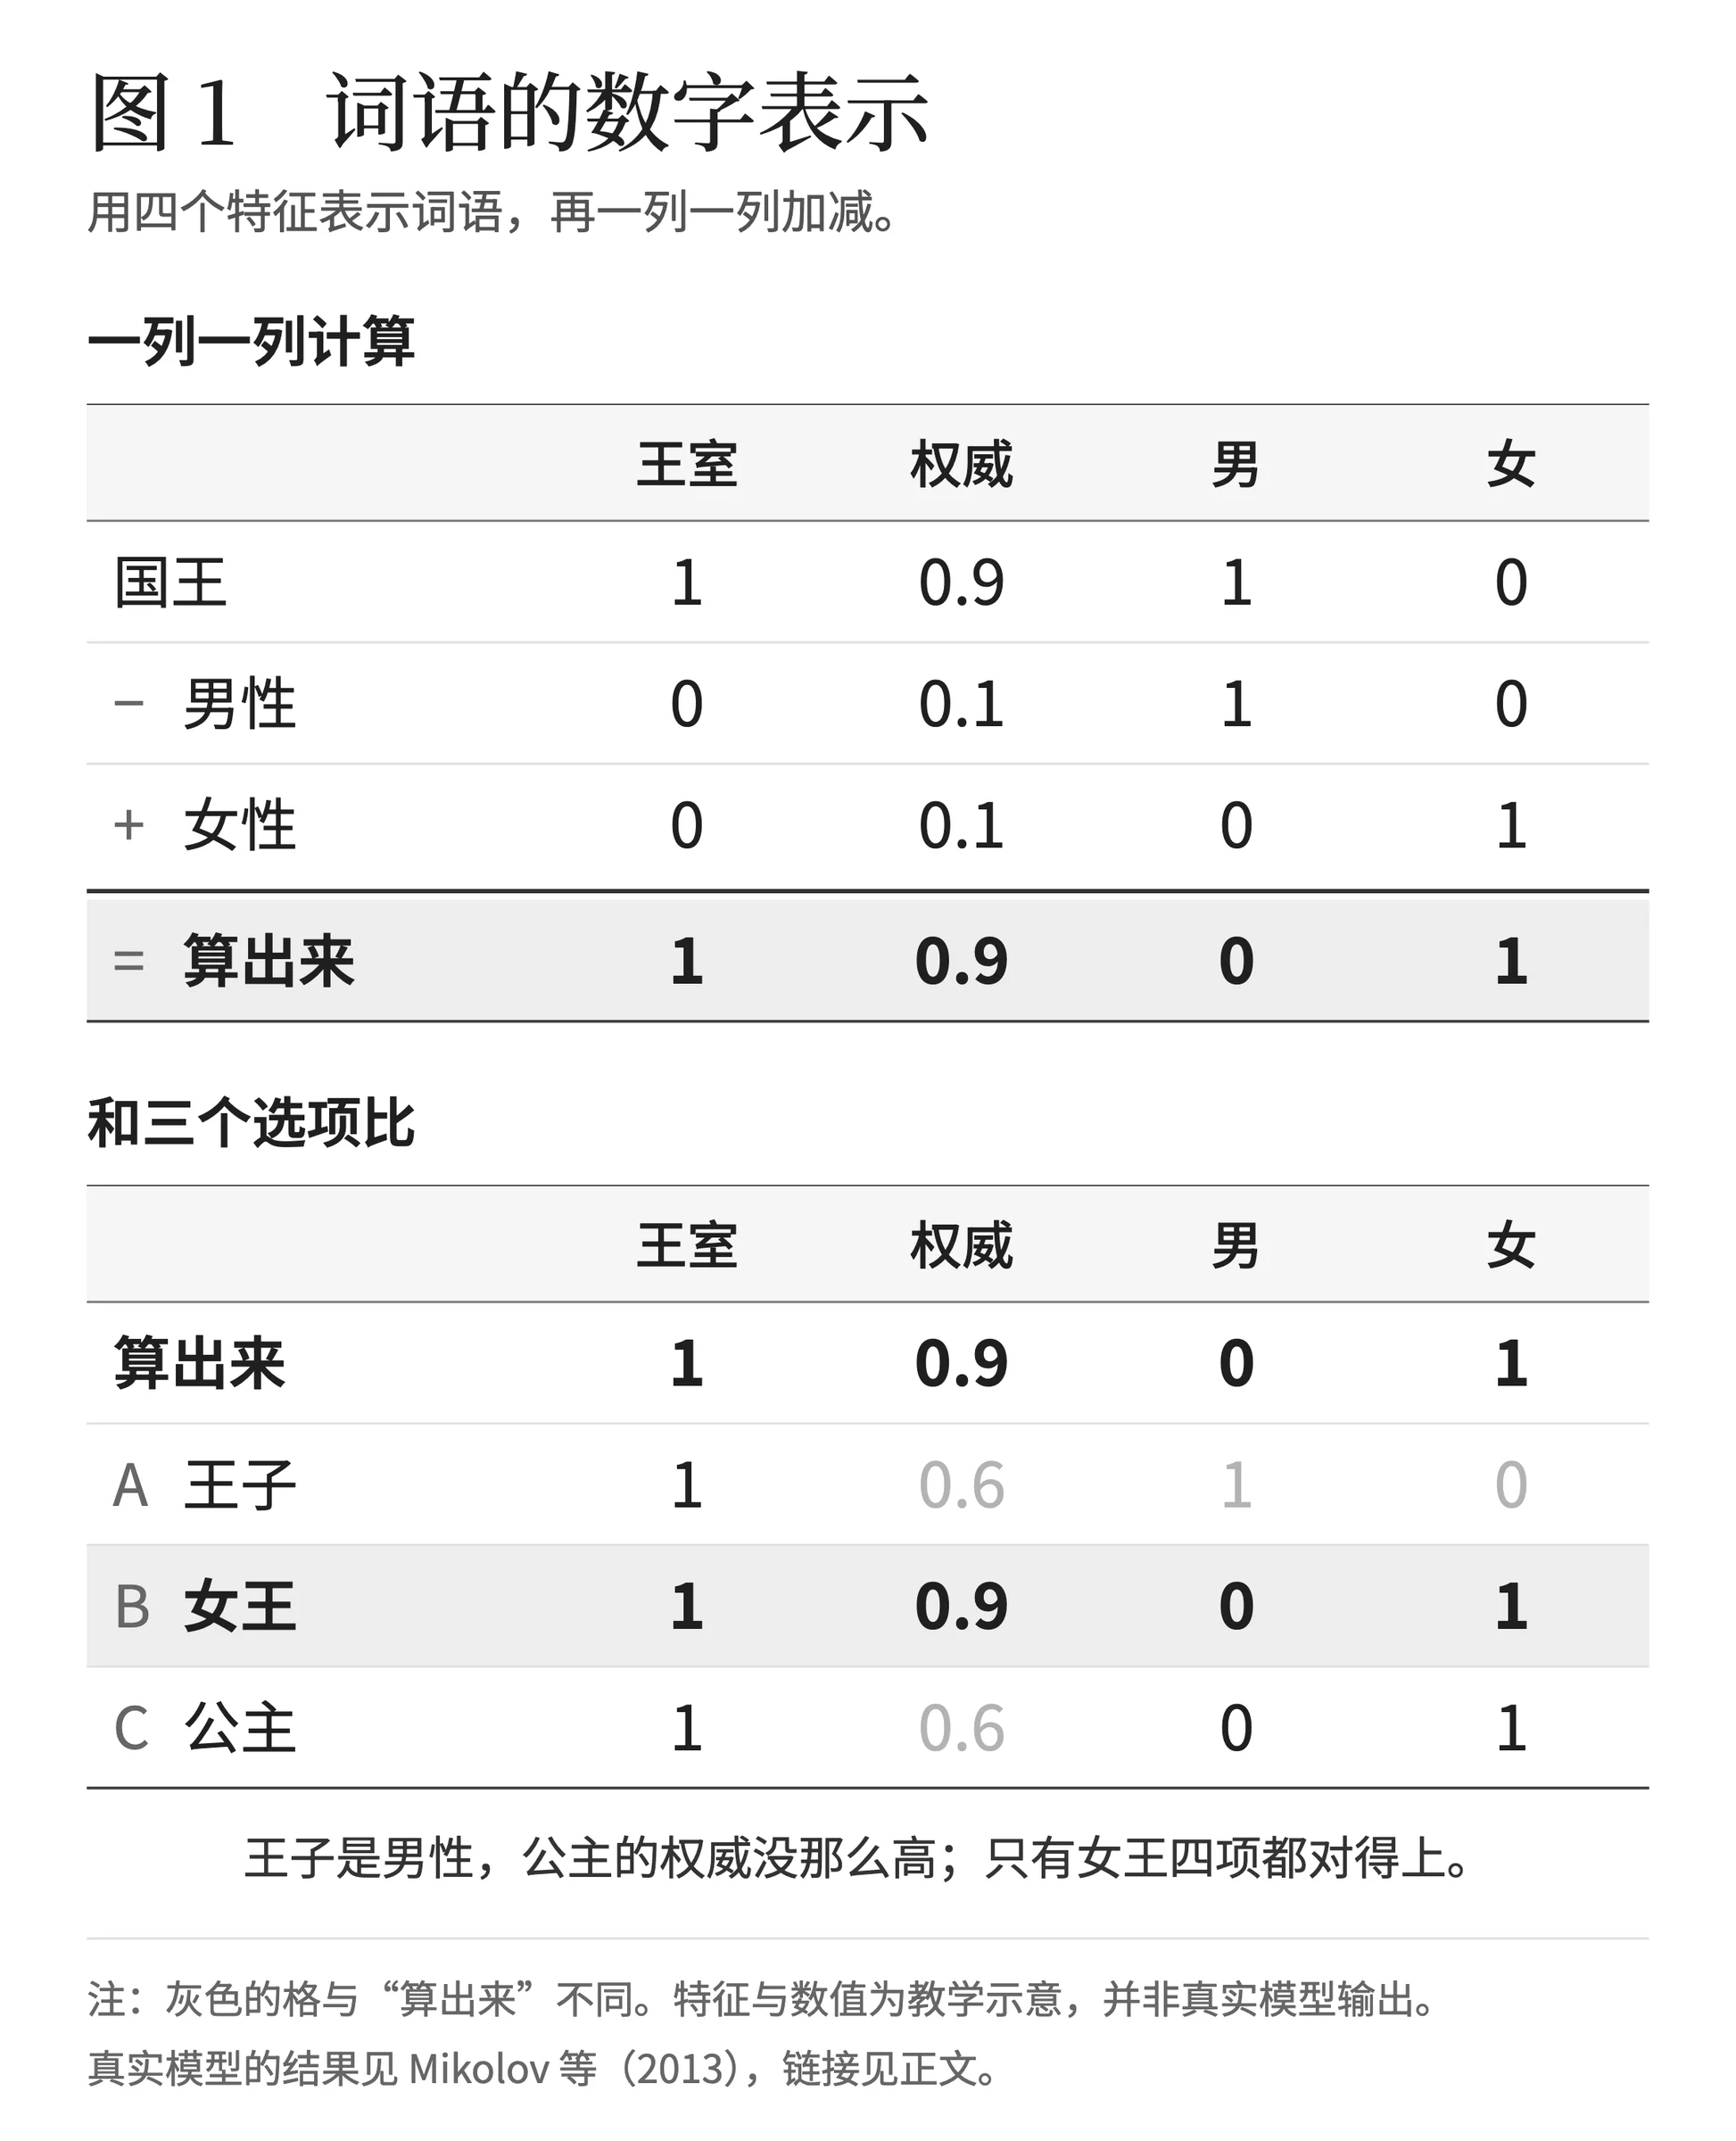
比如“国王”:是王室,记 1;权威很高,记 0.9;是男性,“男”这一项记 1,“女”这一项记 0。按固定顺序排在一起,就是:
[1,0.9,1,0]
再看“男性”和“女性”:都不是王室,记 0;权威一般,记 0.1;不同的只在最后两项,一个是男,一个是女:
- 男性:
[0,0.1,1,0] - 女性:
[0,0.1,0,1]
当词语变成数字,就可以加减。现在来算 国王 - 男性 + 女性,一列一列看:
- 王室:1 - 0 + 0 = 1
- 权威:0.9 - 0.1 + 0.1 = 0.9
- 男:1 - 1 + 0 = 0
- 女:0 - 0 + 1 = 1
算出来是 [1,0.9,0,1]:王室、权威很高、女性。
三个选项里,哪个最接近?王子是男性,公主的权威没那么高,只有女王四项全都对得上:
所以:
国王 - 男性 + 女性 ≈ 女王
当然,这是一个简化的例子:这 4 个特征是专门挑出来的,所以能算得这么整齐。真实模型里的数字是从大量文字里学来的,算出来的结果不会恰好等于某个词,只是离某个词最近。在经典的英文词向量实验里(Mikolov 等,2013),用真实模型计算 king − man + woman,最接近的正是 queen。这也是这里写“≈”、而不写“=”的原因。
真实系统中的单个数字,也不一定对应人能直接命名的概念,比如这里用到的“王室”“权威”。
我们就这样通过数字组合表示不同的概念,并使用简单的计算实现了概念和词语之间的关联。
词语在空间中的“位置”
一组数字除了可以参与计算,也可以当作坐标:两个数字可以标出平面上的一个位置,三个数字可以标出立体空间中的一个位置。
这样,词语就有了可以比较的位置关系。为了方便理解,可以在空间里这样表示不同的词:
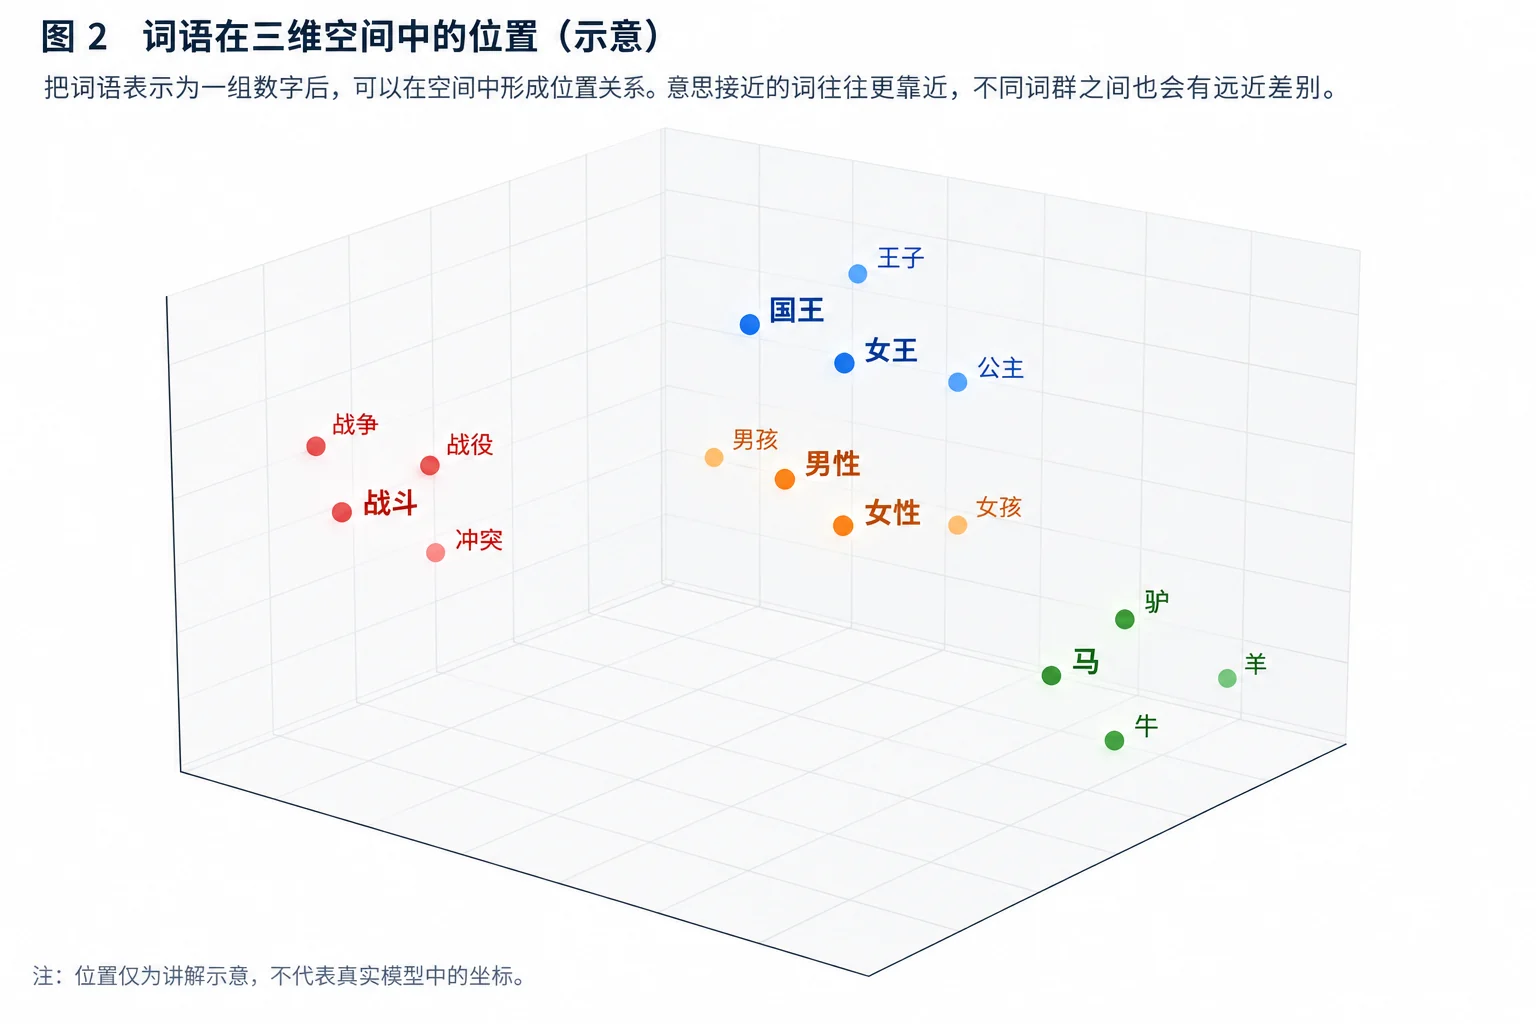
图中,“国王”“女王”“王子”“公主”彼此靠近,“男性”“女性”“男孩”“女孩”也聚在一起。这两组词都与人物有关,所以两组之间的距离也比较近。
“战斗”“战役”“战争”“冲突”形成了另一个小群。“马”“驴”“牛”“羊”则聚在另一处,与前面几组词拉开了距离。
原本只有人类才能理解的文字关联,现在有了一种可以计算和比较的方式。
从表示一个词到表示一篇文档
但查找一项技术,通常不能只输入“笔”这样一个单独的词。
真正需要描述的,可能是它有什么结构、怎样使用、解决了什么问题。这会是一段几百甚至上千字的文字。
模型能够处理的也不只是单个词。在一定长度限制内,一句话、一段专利摘要,或者一篇完整专利文档,都可以被转换成这样一组数字。
比如你想用一句话来搜索一个技术发明:
“按一下按钮,笔尖就能缩进笔杆里。”
这句话经过模型处理后,得到的特征数字组合可能有 1024 个数字(也可以是 512, 2048 等,这是一个预先设定的值):
[0.0237, -0.0412, 0.0085, 0.0569, -0.0174, 0.0328, -0.0641, 0.0106, 0.0453, -0.0297, ......]
另一段资料可能这样描述:
一种书写装置,通过按压机构使书写端在外壳内伸出或收回。
这句话可能表示为:
[0.0251, -0.0386, 0.0097, 0.0538, -0.0191, 0.0305, -0.0608, 0.0124, 0.0470, -0.0279, ......]
如果仔细看,其中会有部分位置的数字比较接近,这可能就是这两句话在某些维度含义相似的地方。但注意这两句话的文字长度虽然不同,但最后处理后得到数字都只有 1024 个,这样才能进行通用的计算。
如果我们的专利库中有 2000 万条专利摘要文本数据,我们需要先把这 2000 万条文字信息先全部处理成 2000 万组这样的数字记录并保存下来。
在进行专利检索的时候,需要先把我们的查询语句 “按一下按钮,笔尖就能缩进笔杆里。” ,转换为上面那样的一组1024 个数字,然后去和已经保存下来的那 2000 万组数字进行比较和计算,找到和查询语句‘距离’最近的前 20条(也可以是更多或更少的条数),作为我们查重/查新检索的搜索结果,再进行后续的分析。
这种检索方式要做的,就是在用词不一样的时候,仍然找到内容相近的资料,而不只是局限于关键词的匹配。想检索是否存在类似发明,只需要直接把自己的发明完整描述出来即可,而不用费力联想关键词,也不需要去学习如何使用复杂的传统检索系统。
这种检索方式也叫:向量检索。这里每一组 1024 个数字,就是代表原始文本的‘向量’。
真实产品中,千万级的向量检索,如何才能做到实际可用
以一个包含2000万条专利摘要的数据库为例,完成两句话的相似度计算,和让这些摘要能够被稳定检索,看似只是数量和工作量的差异,实际这已经是两个不同的问题。
第一步数据收集就有不小难度,我国自 1985 年授予第一批专利权以来,已经有 40 多年时间,但我们并不是从一开始就有完整的信息化数据存储系统和平台。网上并没有一个地方可以让你很容易地免费下载到全量的直接可用的发明专利摘要数据。同时这些数据还在不断增加和更新。
然后要对数据进行统一的处理。除了摘要本身,还要保留文献编号、标题、公开日期等信息。要确保我们通过向量检索找到的每一条结果都能对应回原始的那条专利摘要信息,并核对其原始编号等数据。
接着要把这个示例数据库中的 2000 万条摘要批量转换成表示特征的数字。每一组特征值选多少个数字?256,512, 1024, 还是 2048 ...... ? 数字太少可能无法精确表示语义,搜索精度不好。数字太多,精度可能上去了,但内存和硬盘压力会变大,查询时间也可能慢到不可接受。
然后,还需要建立索引。索引可以理解为一张提前整理好的“数据地图”,查询时不必从第一条记录比到最后一条;但索引怎么建,要在查询速度、资源预算和检索效果之间取舍。
最后,还要用真实查询进行反复测试:结果是否相关,重要资料有没有被漏掉,等待时间是否可以接受。
其中的每一步,又会带来更多新问题。
这些问题,在构建一个真实可用的专利摘要检索系统时,都没有“换一个更强的模型”这类简单的答案。
向量检索帮我们跨过了“字面匹配”这道坎。可资料一多,怎样不必逐条比较,就很快找出最相近的那几条,又是一个新问题。
数据来源和统计范围
“2200多万份”与第一篇口径一致,由团队根据欧洲专利局 DOCDB 数据的2026年夏季历史基线统计,指已收集的中国发明专利申请公开文献,不含实用新型、外观设计、发明授权公告及更正文献。团队于2026年10月23日复核;这不是全国完整累计数,也不是当前有效专利权数量。
上述文献统计没有筛选摘要是否存在,不能直接等同于可用摘要数量。文中的“2000万条摘要”仅为讲解检索过程所设的假设示例。